
 Python 实战 · MOOPROXY FIELD NOTES
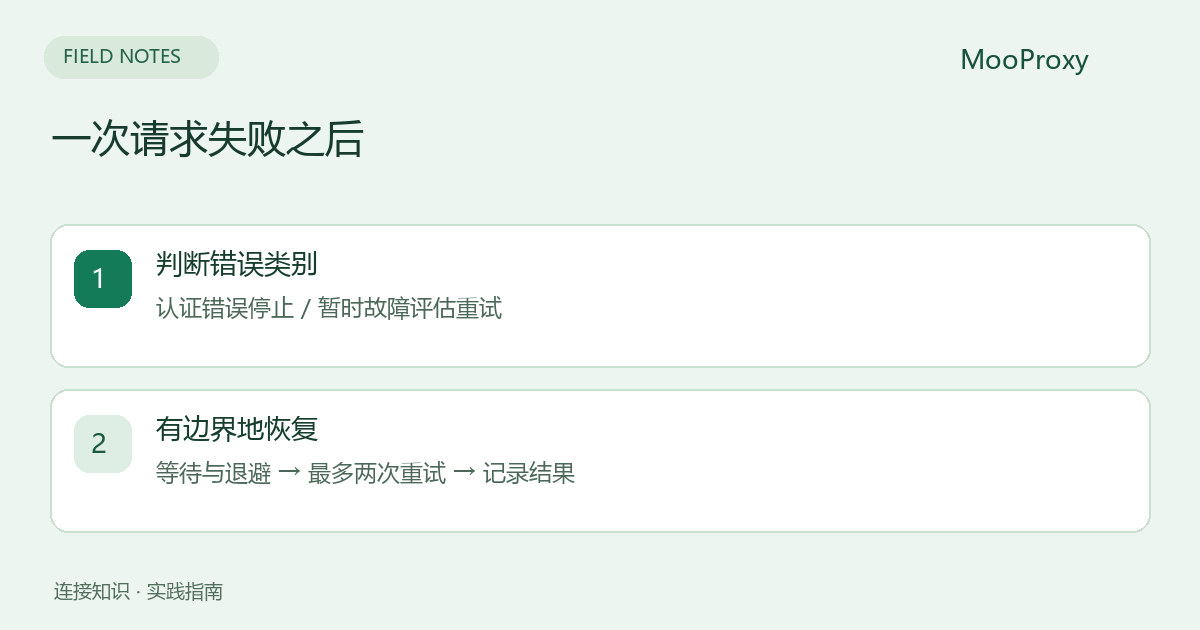
连接超时、读取超时和总截止时间不同
Requests 的 timeout=(8, 20) 将连接超时设为 8 秒、读取等待设为 20 秒。读取超时关注接收数据过程中的等待,不是整个下载的硬性 20 秒截止时间;重试、多个地址尝试和持续返回数据都可能让总耗时更长。[1]
需要任务“最多执行 60 秒”时,应在作业调度或执行进程层设置总截止时间,并取消过期任务。仅把读取超时设成 60 秒,不能实现这个保证。代理认证超时和目标读取超时也应分开记录。
用错误分类决定是否重试
| 情况 | 建议 |
|---|---|
| 407 或 SOCKS 认证失败 | 停止,检查凭据和参数 |
| TLS 证书校验失败 | 核对域名、证书和信任链,不用关闭验证来“修复” |
| 429 限流 | 遵循 Retry-After,减少发送速率 |
| 临时 502 / 503 / 504、连接故障 | 在预算内退避重试 |
| 403 或业务拒绝 | 检查权限与目标要求,不做无上限换 IP 重试 |
| 支付、下单或其他写入请求超时 | 先查业务状态,避免重复执行 |
GET、HEAD 通常适合有限重试,但仍要理解目标接口实际语义。写入操作只有在具备幂等键和服务端去重契约时,才可按那个契约恢复;“没收到响应”不代表“服务端没有执行”。[2][3]
一份适用于只读 GET 任务的起点
依赖:Python 3、Requests SOCKS 扩展及 urllib3 2.x。先安装 python -m pip install "requests[socks]" "urllib3>=2,<3"。用环境变量提供不含认证的 PROXY_HOST、PROXY_PORT,运行时输入完整用户名和密码。
import getpass
import os
from urllib.parse import quote
import requests
from requests.adapters import HTTPAdapter
from urllib3.util import Retry

# PROXY_HOST and PROXY_PORT contain no credentials.
host = os.environ["PROXY_HOST"]
port = int(os.environ["PROXY_PORT"])
user = quote(input("Proxy username: ").strip(), safe="")
password = quote(getpass.getpass("Proxy password: "), safe="")
proxy = f"socks5h://{user}:{password}@{host}:{port}"
retry = Retry(
    total=2, connect=2, read=0, status=2, other=0,
    allowed_methods=frozenset({"GET", "HEAD"}),
    status_forcelist=(429, 502, 503, 504),
    backoff_factor=1, backoff_jitter=0.3,
    respect_retry_after_header=True, raise_on_status=False,
)
with requests.Session() as session:
    session.trust_env = False
    session.proxies = {"http": proxy, "https": proxy}
    adapter = HTTPAdapter(max_retries=retry,
                          pool_connections=4, pool_maxsize=4,
                          pool_block=True)
    session.mount("http://", adapter)
    session.mount("https://", adapter)
    try:
        with session.get("https://example.com/", timeout=(8, 20),
                         allow_redirects=False) as response:
            print("status:", response.status_code)
            response.raise_for_status()
            if 300 <= response.status_code < 400:
                raise RuntimeError("Review redirect before continuing")
            print("decoded body bytes:", len(response.content))
    except requests.RequestException as exc:
        # Do not log the authenticated proxy URL or raw exception.
        print("request failed:", type(exc).__name__)
        raise SystemExit(1)
total=2 是最多重试两次,加上首次最多三次尝试,不是总共两次。示例不重试读取阶段错误,避免接收部分数据后的不确定行为;收到列出的临时 HTTP 状态才按预算恢复。抖动使用 urllib3 2.x 的 backoff_jitter,降低多个工作进程同时重试的概率。
trust_env=False 让环境代理和绕过列表不会改写本例的路由,同时会影响 Requests 的其他环境配置,例如环境提供的 CA bundle;需要企业自定义证书时请显式配置受信任的 CA。示例保留默认 TLS 校验,不输出带密码的代理 URL。
退避不等于整个系统限速
Retry-After 可以要求等待很久,这段等待也会计入实际任务耗时。若不能在业务截止前再次请求,应把任务延后调度,而不是忽略服务端等待时间。单个请求有退避,不代表 100 个 worker 合起来不会超过目标允许速率。
连接池的 pool_maxsize 也不等同于全局并发上限。代码的 pool_block=True 约束这个适配器的池内借用行为;多个进程仍有各自的池。实际并发应由任务队列或信号量明确控制,且不要在没有同步设计时让多个线程共享同一个可变 Session。
保持任务身份,记录有效结果
登录态或多步骤任务恢复时,应保留必要的会话和 Cookie,不能每次失败就随意切换地区与出口。记录任务 ID、尝试次数、错误类别、等待时间、最终状态和内容是否完整;不要记录密码、认证 URL 或敏感 Cookie。
最后把响应内容也纳入验收:200 可能是登录页,JSON 也可能含业务错误。只统计“请求没有抛异常”,会高估成功率并低估每条有效结果的成本。
参考资料与编辑说明
资料核对:2026-10-19。本文为官方文档基础上的原创整理;代码为配置示例,不代表生产性能承诺。
准备好验证你的连接了吗?
从控制台生成配置,按指南完成小样本测试。