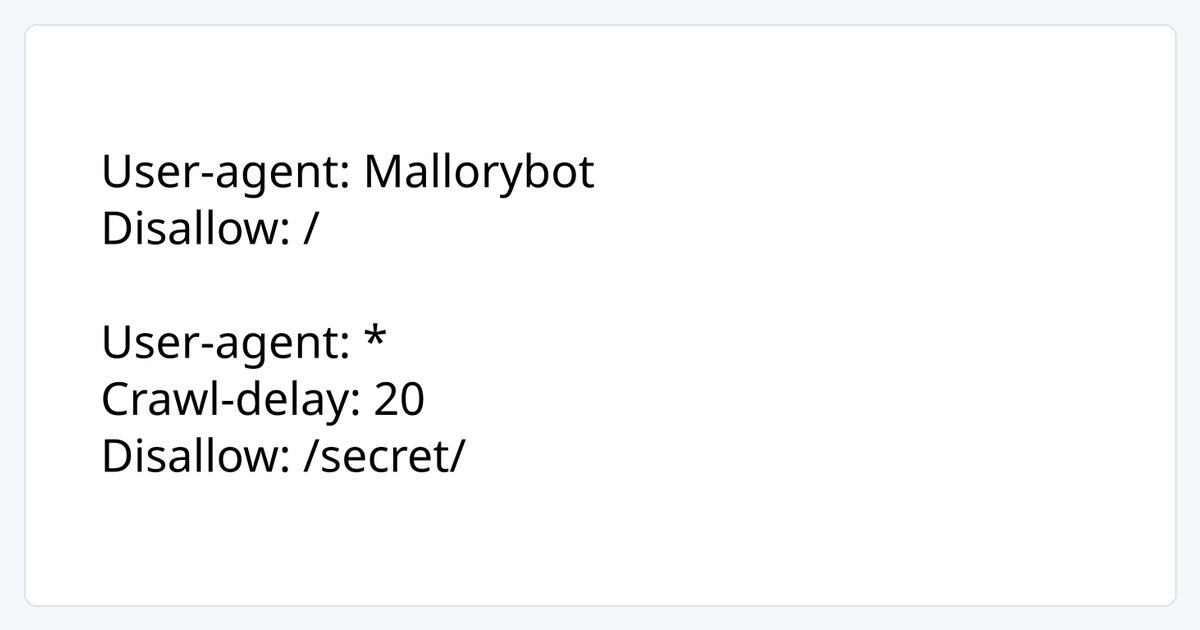

图中 Crawl-delay 是部分爬虫支持的扩展,不属于 RFC 9309 的核心规则,不同工具可能忽略它。
先判断有没有访问权限
优先使用目标网站提供的官方 API 或数据导出,并阅读服务条款、用途限制和隐私要求。公开可见不等于允许任意采集、再分发或高频访问。对于个人信息、登录后内容和受限制页面,应先确认明确授权。
robots.txt 是爬虫排除协议,不是授权许可,也不是安全访问控制。即使没有禁止规则,也仍需遵守适用条款和法律。
正确读取 robots.txt
访问目标站点根目录的 /robots.txt,根据自身的 User-Agent 识别适用规则。RFC 9309 对匹配、允许与禁止规则有定义;站点的其他说明及工具实现也要一并核查。不要把 Disallow 路径当成受保护资源清单,更不要尝试绕过限制。
curl -sS --connect-timeout 8 --max-time 20 https://example.com/robots.txtexample.com 仅是占位域名。记录获取时间、状态码、适用 User-Agent 和规则版本;读取失败、超时、重定向或文件不存在时,不应自动视为站点授权,先查看服务条款或联系数据提供方。
限速、退避与识别
为每个目标主机设置独立并发和请求速率上限;先从低频小批量开始。收到 429 Too Many Requests 时停止增加负载,遵守可能存在的 Retry-After,在有限重试预算内退避。遇到 403、验证码或登录墙时应停止并核查权限,不要依靠轮换 IP 绕过限制。
使用能够识别的 User-Agent 和联系渠道,并避免在日志中保存不必要的个人数据或认证信息。
验证数据而不是只计成功请求
- 保存采集时间、来源 URL、地区与必要的响应状态。
- 校验预期字段、数据类型、币种和日期;识别验证页或登录页。
- 去重并标记缺失,设置数据保留期限。
- 定期复核目标规则、异常率和内容变化,必要时暂停任务。
可结合 curl 代理验收指南 对出口与响应分层检查。
参考资料与编辑说明
资料核对:2026-10-29。本文根据下列资料原创整理,示例仅用于说明。